Distribución Binomial y Distribución Normal: Dos Modelos para Datos Distintos
La distribución binomial modela el número de éxitos cuando se repite un ensayo con dos resultados posibles, así que corresponde a los datos que se cuentan.
La distribución normal describe variables continuas que se reparten de forma simétrica alrededor de su media, así que corresponde a los datos que se miden.
Este artículo explica las dos distribuciones, calcula una probabilidad binomial paso a paso y muestra cómo se lee la regla empírica de la normal.
Qué es la distribución binomial y cuándo se usa
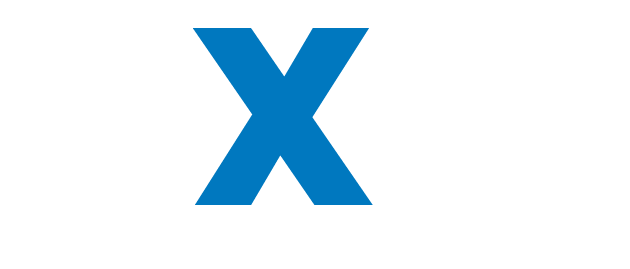
La distribución binomial es la distribución de probabilidad de la variable \(X\), que cuenta el número de éxitos obtenidos en \(n\) ensayos independientes.
Un experimento binomial reúne tres características:
- Número fijo de ensayos: el experimento se repite un número fijo de veces.
- Dos resultados por ensayo: solo hay dos resultados posibles en cada ensayo.
- Independencia: los ensayos son independientes y se repiten en condiciones idénticas.
Al resultado que se cuenta se le llama éxito y al otro, fracaso; la probabilidad de éxito se escribe \(p\) y la de fracaso, \(q\).
Como los dos resultados son los únicos posibles, entre las dos probabilidades suman uno, y de ahí la igualdad \(p + q = 1\) de todo problema binomial.
La probabilidad de obtener exactamente \(x\) éxitos se calcula con la fórmula \(P(X = x) = C(n, x) \cdot p^{x} \cdot q^{n – x}\).
El factor \(C(n, x)\) es el coeficiente binomial, y cuenta de cuántas formas se pueden repartir \(x\) éxitos entre los \(n\) ensayos.
El coeficiente binomial es también el número de maneras de elegir \(x\) elementos de una colección de \(n\), es decir, un cociente de factoriales.
Por eso el coeficiente binomial aparece en la fórmula: ordena las posiciones de los éxitos, y el resto de la expresión multiplica la probabilidad de cada ordenación.
| Elemento | Qué representa | Cómo se reconoce en el problema |
|---|---|---|
| \(n\) | El número de ensayos | Una cantidad fija de repeticiones del mismo ensayo |
| \(p\) | La probabilidad de éxito en un ensayo | Una proporción que se repite igual en cada ensayo |
| \(q\) | La probabilidad de fracaso | La diferencia \(1 – p\) |
| \(x\) | El número de éxitos que se pide | El valor concreto cuya probabilidad se busca |
| \(C(n, x)\) | El coeficiente binomial, que aquí vale \(n! / [x!\,(n – x)!]\) | El número de formas de repartir \(x\) éxitos entre \(n\) ensayos |
Ejemplo 1: calcular una probabilidad binomial paso a paso
Situación: en un colegio, el 60 % de los estudiantes viaja en bus, y se eligen 8 estudiantes al azar para preguntarles cómo llegan.
Paso 1. Se fijan los datos del modelo: el número de ensayos es \(n = 8\) y la probabilidad de éxito es \(p = 0{,}6\).
Paso 2. Se obtiene la probabilidad de fracaso con la igualdad \(p + q = 1\), y resulta \(q = 0{,}4\).
Paso 3. Se pide la probabilidad de que exactamente 5 de los 8 estudiantes viajen en bus, es decir, \(P(X = 5)\).
Paso 4. Se calcula el coeficiente binomial, y \(C(8, 5) = 56\).
Paso 5. Se elevan las dos probabilidades: \(0{,}6^{5} = 0{,}07776\) y \(0{,}4^{3} = 0{,}064\).
Paso 6. Se multiplican los tres factores, y \(56 \cdot 0{,}07776 \cdot 0{,}064 = 0{,}27869184\).
Desarrollo completo:
\[P(X = 5) = C(8, 5) \cdot 0{,}6^{5} \cdot 0{,}4^{3} = 56 \cdot 0{,}07776 \cdot 0{,}064 = 0{,}27869184\]
Resultado: la probabilidad es \(0{,}2787\), la media es \(\mu = np = 4{,}8\) estudiantes y la desviación es \(\sigma \approx 1{,}3856\).
Qué es la distribución normal y cómo se lee su gráfica
La distribución normal es una distribución de probabilidad continua y simétrica alrededor de su media, y su gráfica dibuja una forma de campana.
Por su forma redondeada, los físicos a veces la llaman gaussiana y las ciencias sociales, curva de campana.
La distribución se escribe \(X \sim N(\mu, \sigma)\), donde \(\mu\) es la media y \(\sigma\) la desviación estándar, que son los dos parámetros que la definen.
Para comparar un valor con su distribución se usa el puntaje \(z\), que indica cuántas desviaciones estándar está ese valor por encima o por debajo de la media.
El cálculo es \(z = \dfrac{x – \mu}{\sigma}\), y el resultado se mide en unidades de desviación estándar.
Al aplicar esa transformación se obtiene la normal estándar, con media 0 y desviación estándar 1, que se escribe \(Z \sim N(0, 1)\).
En una variable continua la probabilidad se lee como el área bajo la curva: \(P(X < x)\) es el área a la izquierda de \(x\), y el área a la derecha es \(1 – P(X < x)\).
La regla empírica de la distribución normal
La regla empírica describe cómo se reparten los datos de una distribución normal alrededor de su media.
Sus tres tramos se miden en desviaciones estándar desde la media:
- Una desviación estándar: cerca del 68 % de los valores cae entre \(\mu – \sigma\) y \(\mu + \sigma\).
- Dos desviaciones estándar: cerca del 95 % de los valores queda dentro de ese intervalo.
- Tres desviaciones estándar: alrededor del 99,7 % de los valores queda dentro de ese intervalo.
Por eso casi todos los valores se concentran a tres desviaciones estándar de la media, con muy pocos casos en los extremos.
Esta regla se conoce también como la regla 68-95-99,7.
Ejemplo 2: aplicar la regla empírica y el puntaje z paso a paso
Situación: los puntajes de un examen se distribuyen de forma aproximadamente normal, con una media de 70 puntos y una desviación estándar de 10 puntos.
Paso 1. Se calcula el intervalo de una desviación estándar, que va de \(70 – 10 = 60\) a \(70 + 10 = 80\).
Paso 2. Se calcula el intervalo de dos desviaciones estándar, que va de 50 a 90, donde cae cerca del 95 % de los puntajes.
Paso 3. Se calcula el intervalo de tres desviaciones estándar, que va de 40 a 100, donde cae alrededor del 99,7 %.
Paso 4. Se busca el puntaje \(z\) de un examen con 85 puntos, y resulta \(z = (85 – 70) / 10 = 1{,}5\).
Desarrollo completo:
\[70 – 10 = 60 \quad \text{y} \quad 70 + 10 = 80\]
\[50 \le x \le 90 \quad \Rightarrow \quad 40 \le x \le 100\]
\[z = \frac{85 – 70}{10} = 1{,}5\]
Resultado: un puntaje de 85 está una desviación y media por encima de la media, y casi todos los puntajes quedan entre 40 y 100.
Cuándo se usa cada modelo
La elección entre los dos modelos depende del tipo de dato: la binomial cuenta éxitos en ensayos repetidos y la normal mide una cantidad continua.
Cada modelo queda definido por sus parámetros:
- Binomial: queda definida por el número de ensayos \(n\) y la probabilidad de éxito \(p\).
- Normal: queda definida por su media \(\mu\) y su desviación estándar \(\sigma\).
Atributos comunes como los puntajes de un examen o la estatura siguen aproximadamente distribuciones normales, con pocos casos en los extremos.
La tabla siguiente compara los dos modelos en los rasgos que más se preguntan en un examen.
| Aspecto | Distribución binomial | Distribución normal |
|---|---|---|
| Tipo de dato | Discreto: cuenta el número de éxitos | Continuo: mide una cantidad cualquiera |
| Resultados por ensayo | Dos: éxito o fracaso | No hay ensayos: la variable toma cualquier valor de un intervalo |
| Parámetros | \(n\) y \(p\) | \(\mu\) y \(\sigma\) |
| Gráfica | Barras, una por cada número de éxitos | Una curva en forma de campana |
| Cómo se calcula | Con la fórmula del coeficiente binomial | Con el área bajo la curva, por tablas o calculadora |
| Ejemplo típico | Aciertos en un número fijo de intentos | Estaturas, puntajes o tiempos de un grupo |
Estrategias para el examen y errores frecuentes
- Identificar primero si el dato se cuenta o se mide, porque eso decide entre la binomial y la normal.
- Comprobar que el experimento binomial cumple las tres condiciones: ensayos fijos, dos resultados e independencia.
- Recordar que \(q = 1 – p\), y que en la fórmula los exponentes de \(p\) y \(q\) suman \(n\).
- No confundir el coeficiente binomial con la probabilidad: hay que multiplicarlo por las potencias de \(p\) y \(q\).
- Calcular el puntaje \(z\) antes de comparar valores de dos distribuciones normales distintas.
- Memorizar los tres tramos de la regla empírica: 68 %, 95 % y 99,7 %.
Conclusión
La distribución binomial y la distribución normal son dos modelos para dos tipos de datos: los que se cuentan y los que se miden.
La binomial se apoya en \(n\) y \(p\), y su probabilidad sale de la fórmula con el coeficiente binomial.
La normal se apoya en \(\mu\) y \(\sigma\), y su lectura combina el puntaje \(z\) con la regla empírica.
Referencias Bibliográficas
- Illowsky, B., & Dean, S. (2023). Introductory Statistics 2e (secciones 4.3 y 6.1). OpenStax. https://openstax.org/books/introductory-statistics-2e/pages/4-3-binomial-distribution y https://openstax.org/books/introductory-statistics-2e/pages/6-1-the-standard-normal-distribution
- Orloff, J., & Bloom, J. (2022). Class 4: Discrete random variables [Reading 4a]. 18.05 Introduction to Probability and Statistics. MIT OpenCourseWare. https://ocw.mit.edu/courses/18-05-introduction-to-probability-and-statistics-spring-2022/mit18_05_s22_class04-prep-a.pdf
- Weisstein, E. W. (s. f.). Binomial distribution. MathWorld–A Wolfram Web Resource. https://mathworld.wolfram.com/BinomialDistribution.html
- Weisstein, E. W. (s. f.). Normal distribution. MathWorld–A Wolfram Web Resource. https://mathworld.wolfram.com/NormalDistribution.html
Sigue estudiando: Operaciones con intervalos: unión, intersección y complemento y Cómo determinar el dominio y el ámbito de una función en una gráfica.